方坯端面钢坯号识别技术方案:五类失效模式、选型依据与工程落地
方坯端面钢坯号识别技术方案:五类失效模式、选型依据与工程落地
引言
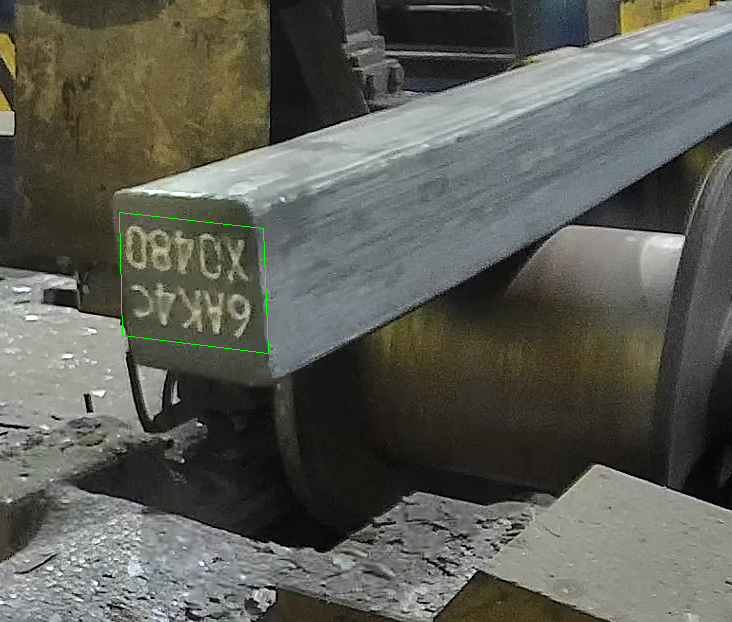
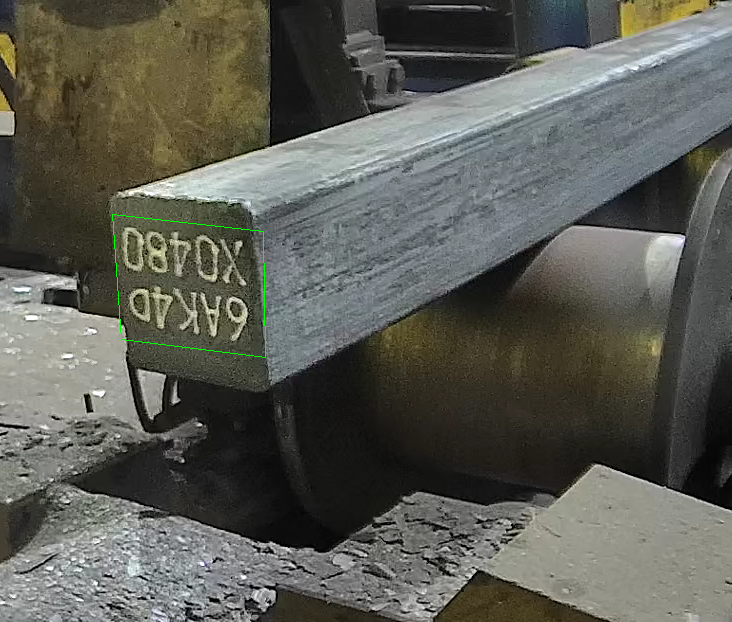
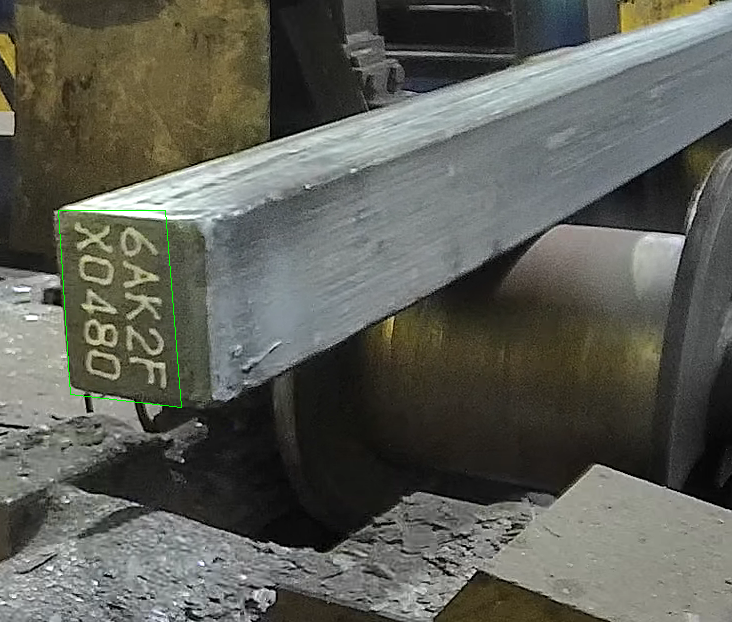
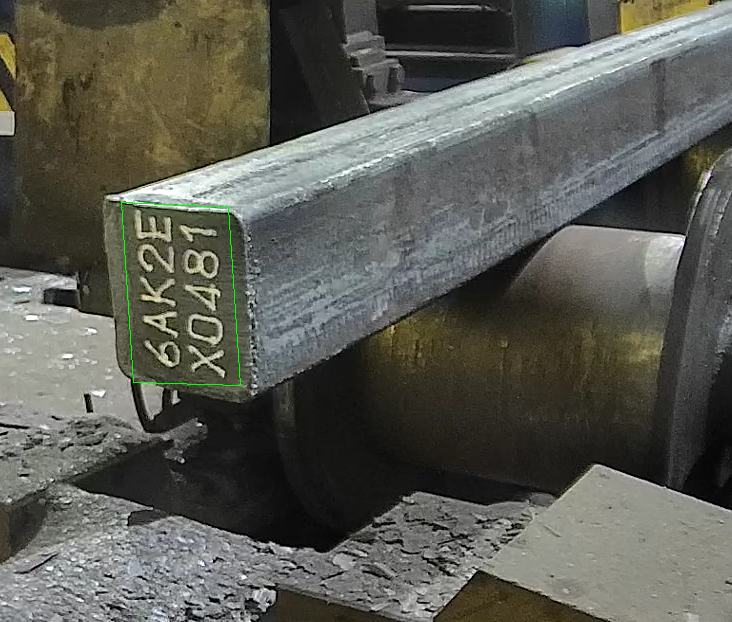
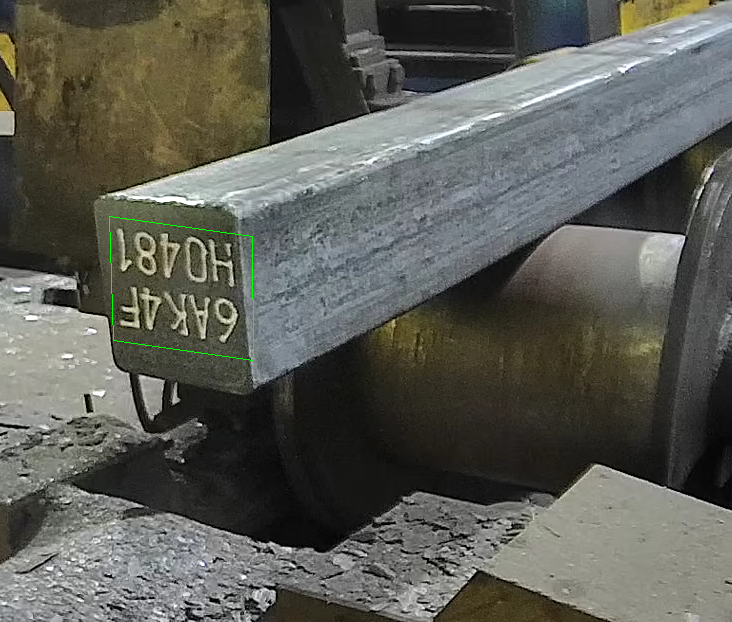
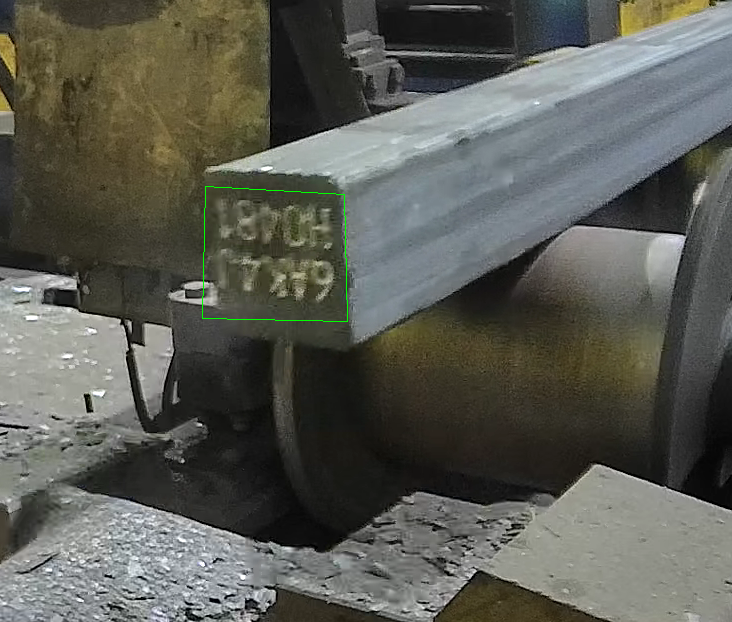
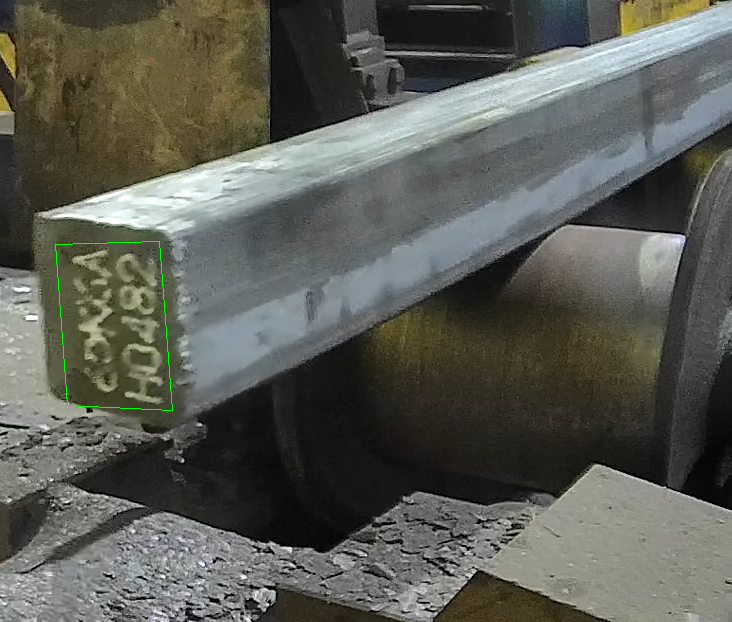
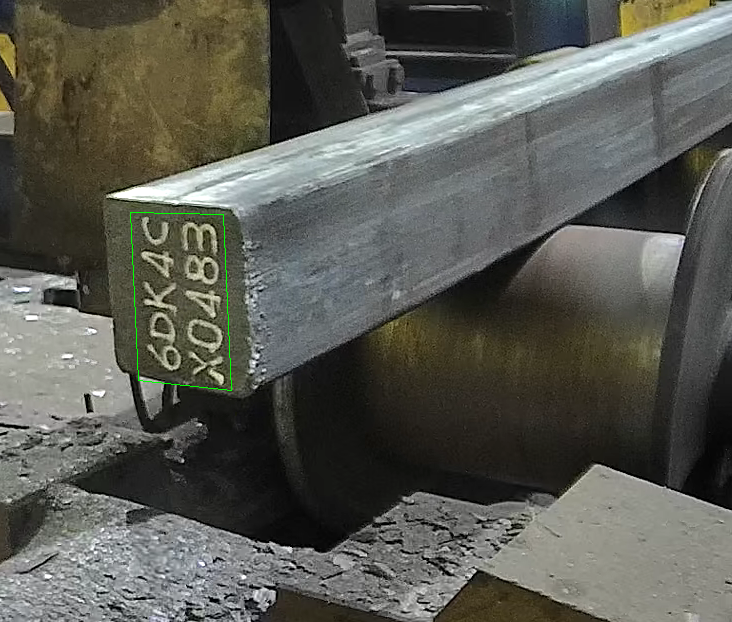
钢坯端面字符识别,看起来是”OCR 换个场景”,实际是三类问题的叠加:成像条件恶劣(金属镜面反光、氧化皮、粉尘、冲压凹陷导致对比度极低甚至极性反转)、目标姿态不受控(竖排、字头朝左或朝右,随翻坯动作变化)、结果必须可信(一个字符读错,追下去就是整炉、整批的质量追溯断链)。
这三件事决定了它不能按”通用 OCR 换个数据集重训”的思路做。本文面向已经在做工业视觉、准备落地或正在被识别率卡住的读者,按”失效模式 → 模块选型 → 数据 → 训练 → 部署 → 验收”的顺序展开,重点不在于给出某套模型名字,而在于给出选型的判据:什么条件下某个方案才有意义,什么条件下它是白花钱。
先给三条前置结论,后面逐条论证:
- 识别率的瓶颈通常不在识别模型,而在定位、姿态、成像三条链路上的条件归一。籽料级(crude)图像没归一好,换更大的识别模型只是把 87% 抬到 89%。
- “用两个识别模型的置信度比大小”是一种不可靠的融合方式。CTC 与 Attention 输出的分数不在同一个概率尺度上,不校准就没可比性;即便校准,”两模型都错在同一处”时融合收益为零。融合要先算错误相关性,再决定做不做。
- 性价比最高的一层往往不是模型,而是业务先验:编码格式、校验位、MES 台账白名单。把”纯视觉识别”变成”字典内受限解码”,是从 97% 走到 99.9% 最省力的一步——但它同时会引入”错读被硬掰成另一个合法号”的新风险,必须配套防护。
一、先把”识别率上不去”拆成五个独立失效模式
工程上最容易犯的错,是把所有失败样本当成一个笼统的”识别率问题”,然后统一交给一个更大的模型去解决。先做失效归因,每个失效模式有独立的表征、独立的代价结构、独立的归属模块:
| 失效模式 | 典型表征 | 直接后果 | 归属模块 | 主要代价 |
|---|---|---|---|---|
| ① 定位失败 | 框偏、框漏、框住两段字符 | 后续一切无效 | 检测 / ROI 配准 | 漏检需重拍,节拍损失 |
| ② 姿态未归一 | 竖排/倒置直接进识别 | 输出整串乱码,且置信度极低 | 姿态分类 / 几何校正 | 大面积返工,且难以察觉 |
| ③ 成像条件未归一 | 反光斑盖住笔画、极性反转(亮字/暗字混用) | 字符”看起来”在但模型读不出 | 光学 + 图像增强 | 需改硬件或补光,成本最高 |
| ④ 字符退化 | 断笔、粘连、氧化皮遮挡、压印过浅 | 个别字符错,位置级错误 | 识别模型 + 数据 | 靠数据与合成补,边际递减 |
| ⑤ 先验缺失 | 视觉结果无校验,直接下发给 MES | 错误被无条件信任 | 后处理 / 业务约束 | 单点错号造成追溯事故 |
这张表的价值在于:它能告诉你钱该花在哪。 如果失败样本里 ② 占七成,你上 SVTR、上融合、扩数据,全都不会动;把姿态归一做好,第二天就能见效。所以第一步不是选模型,是把 500 张失败样本按这五类标注归因,得到一张分布图。
类比一下:这像修水管查漏。你先确定是接头漏、管壁裂还是水压过高,再去买配件;不定位就换整根管子,钱花了,漏点还在原处。对应关系是:漏点分布对应失效模式分布,配件对应模块方案,水压对应数据与成像条件。这个比喻的边界也要说清——水管漏点可以被逐个封堵,而模型失效模式之间存在耦合(姿态错了会伪装成”字符退化”),所以归因要看到原图与中间结果,不能只看最终字符串。
二、架构:为什么是级联,而不是端到端
端到端(一张图直接出字符串)在学术上很优雅,在工业上通常不划算。原因有三个,都是工程性的:
- 误差不可定位。端到端错了,你只能看到”字符串错”,无法区分是没找到、找歪了还是读错了,迭代方向只能靠猜。
- 样本效率差。级联结构里检测和识别各自只学一件事,可以用合成数据、可以借预训练;端到端要同时学定位与字符,同等数据量下更难收敛。
- 无法分阶段验收。产线改造要分期上线,级联允许”先只上定位+人工复核”,端到端没有这种中间可用状态。
代价也要讲清楚:级联会传播误差——上游 1% 的漏检,在下游就是 1% 的必然失败,且下游无法恢复。所以级联设计的核心不是把每一级做到最强,而是在级间做冗余与可恢复性:定位给两个候选框(主框 + 扩边备用框)、识别对同一区域做两套预处理、后处理保留 top-k 候选而不是只留 top-1。级联不是流水账,是带冗余的流水线。
图 1:带冗余的六段级联。橙色两级是”条件归一”,绿色是识别与融合,蓝色是业务约束。虚线为学习闭环。
三、模块选型与依据
3.1 定位:先问”ROI 能不能固定”,再谈模型
这是最容易被跳过、也最能省钱的一问。检测模型的存在意义是”目标位置不确定”;如果端面在视场里位置相对固定,用固定 ROI + 模板配准(相位相关/特征点)就能拿到框,延迟从毫秒级降到亚毫秒级,且完全不依赖训练数据。
| 方案 | 适用判据 | 优点 | 代价与风险 |
|---|---|---|---|
| 固定 ROI | 相机与坯料相对位置稳定,规格少(端面尺寸变化 < 15%) | 零训练成本、零漏检、延迟最低 | 换规格/换工位需重标;坯料歪斜时框内字符出界 |
| 模板配准 + ROI | 位置有平移/轻微旋转,但字符区纹理可锚定 | 免训练,能补偿小幅位姿 | 氧化皮、油污会破坏配准;需设配准失败兜底 |
| HBB 目标检测(YOLO 系) | 位置不固定、背景复杂,字符行基本水平或在框内可容纳 | 生态成熟、部署简单、易增量训练 | 竖排时水平框内背景占比高,裁剪后字符被压缩变形 |
| OBB 旋转框检测 | 字符行与图像轴存在稳定夹角,且水平框内背景确实干扰识别 | 框贴合、裁剪后不需猜测角度 | 标注成本高(需旋转框)、小目标角度回归不稳、模型与部署链更复杂 |
| 分割(文本区域分割) | 字符与背景对比度低但成片连续、框回归难以收敛 | 对粘连/弱边界更鲁棒 | 需要像素级标注,后处理重,节拍压力大 |
选型的关键判据只有两个:框内背景占比和姿态是否离散。把失败样本裁出来,量一下”水平框内非字符像素比例”,如果超过 50%,HBB 就是错的,此时要么上 OBB,要么先在 3.2 的姿态归一里解决角度问题——注意这两条路不是一回事(见下节)。
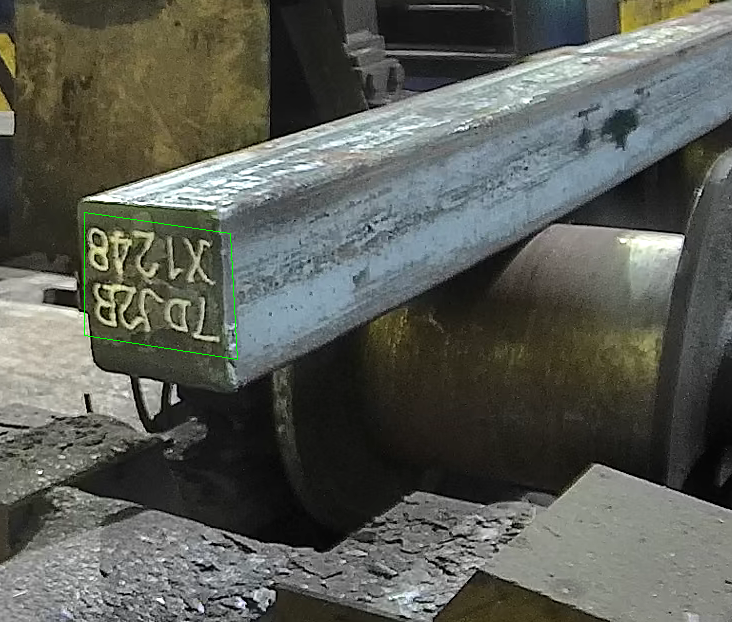
还有一条常被忽略的判据:字符是”整行”还是”分字段”。从样例看是两段(如 7DA7F 与 X0216),如果两段在端面上有稳定间隔,更优的做法是检测两个独立框、两段独立识别,而不是一个大框整行读。理由:整行读时 CTC 的对齐要跨过间隔,一处对齐错位会连累两段;分段读则每段独立校验、独立降级,错误不会串。
3.2 姿态归一:OBB 管”框”,分类器管”行方向”,别混为一谈
这一点需要说得更细,因为它是本方案里最容易被误解的地方。
- OBB 解决的是”框贴合”:让框跟着字符行的角度转,从而裁出不含多余背景的图。
- 方向分类器解决的是”阅读方向”:判断这行字是 0°/90°/180°/270° 中的哪一种,把图物理旋转到”从左到右、从上到下”的正向,再交给识别模型。
两者可以同时用,也可以只用后者。判据是姿态分布的离散程度:
- 若统计 3.6 万张图的姿态直方图,发现 95% 以上落在 4 个方向 ±10° 内(钢坯在辊道上的姿态由翻钢机、移坯机几何决定,通常就是离散几种),那么连续角度回归(OBB)在这一维上是浪费——你只需要 4 类分类 + 一次
warpAffine,模型小到可以在 CPU 上跑到亚毫秒,而且分类器的错误模式简单可控。 - 若同时存在 ±10°~±15° 的随机倾斜(相机安装偏、坯料歪斜),正确顺序是:先 OBB 或最小外接矩形做几何拉正,再 4 类分类做方向判定。因为分类器对 ±15° 的倾斜不敏感,但对 90° 的象限错误极其敏感,两者互补。
- 若姿态是连续且大范围变化(例如人工上料、多工位混线),那么 4 类分类不成立,只能走 OBB 连续角 + 透视变换,并在训练时把角度抖动做进增强。
还有一个必须承认的事实:方向错误在监控上几乎不可见。它不报错,只是输出一串低置信度的乱码,如果后处理只看”是否有结果”,就会把乱码当结果下发。所以姿态模块必须自带一致性检查:分类器置信度低于阈值时,不要”猜一个方向”,而是把四个方向各跑一遍识别、取最高分——代价是 4 倍延迟,只在疑难样本上触发。
数据层面还有一条纪律:标注时一律按”转正后的阅读顺序”转录(如 7DA7F X0216),忽略原图方向。这样同一个物理字符串在不同姿态下产生的是同一条标签,模型学的是”识别”,而不是”识别 + 记姿态”。这条纪律不做,后面所有评估指标都会失真。
3.3 成像条件归一:优先级高于任何模型选择
钢坯端面是金属镜面 + 冲压凹陷,两个物理现象会直接摧毁识别:
- 极性反转:冲压字符是凹凸的,光源方向决定它是”亮字暗底”还是”暗字亮底”。同一批坯料因工位补光角度不同,可能出现两种极性混在一起。模型可以靠数据学会两种极性,但会挤占容量,且对没见过的极性组合更脆弱。
- 镜面反光斑:一旦高光斑覆盖笔画交叉区,信息在物理层面已经丢失,任何算法都补不回来。
处理顺序应该是先光学、再算法:
- 光学层(最优):低角度环形光或同轴光把凹陷打出阴影对比;偏振片压金属反光;必要时加遮光罩隔离环境光。这一层的投入产出比通常高于算法调优——把反光斑面积压下去,识别率是跳变而不是渐变。
- 算法层:局部对比度归一(CLAHE 分块,块尺寸要大于字符间距,否则会把笔画增强成噪声)、顶帽/底帽双通道(top-hat 提亮字、black-hat 提暗字,二选一或取局部对比度更大的通道)、去尘与划痕的形态学开运算。
- 训练层:把”极性随机翻转”作为固定增强项,让模型对极性不敏感,作为光学没做到位时的兜底。
判据也要量化,不要凭感觉:统计失败样本中”反光斑覆盖字符笔画面积 > 20%”的比例。这部分样本属于不可恢复集,应当从模型评估里剔除、单独作为光学改造的依据;把它们留在测试集里,你会得到一个永远达不到的指标,然后误以为是模型不行。
3.4 识别:三种建模范式,先按”长度是否固定”选
不要一上来就在 CRNN 与 SVTR 之间做选择,先选范式。钢坯号的现实是定长、有限字符集、分段,这三点让”逐槽位分类”成为一个被严重低估的选项:
| 范式 | 建模方式 | 适用判据 | 优势 | 局限 |
|---|---|---|---|---|
| 序列识别(CTC) | CNN + 序列头,CTC 解码 | 字符粘连、长度可变、点阵喷码断笔 | 工业标准,鲁棒,无需字符切分 | 置信度是路径边际,长度相关,难以逐位解释 |
| 逐槽位分类(定长) | N 个位置的 N×C 分类头,或整行展平后按位监督 | 长度固定、字符间距稳定(钢印/冲压常见) | 天然给出逐位置信度,便于逐位校验与字典比对;无 CTC 对齐问题;模型更小 | 长度一变就要改结构;字符严重粘连时退化 |
| 单字符检测 + 分类 | 先检测每个字符框,再分类 | 字符彼此分离、独立凸起明显 | 可定位到具体字符,错误可解释,便于人工核对 | 分割错误会连锁;小字符检测难,节拍压力大 |
对”字母+数字、定长、分两段”的钢坯号,逐槽位分类是首选,理由不是精度,而是可解释性与可校验性:它输出的是”N 个位置上的字符分布”,你可以直接拿第 3 位去和台账比对,也可以把逐位概率拼成整行可信度,后处理极其自然。CTC 的整行分数则是一个难以拆解的数,这正是”用置信度融合”在实际项目里常常难以奏效的根源之一。
如果字符确实粘连严重、或同一工位混着点阵喷码与钢印两种工艺,那就退回序列识别,并接受它的置信度不天然可拆解——这不是缺点,是选择代价。
至于 CRNN 与 SVTR 之间:
- CRNN(CNN + BiLSTM + CTC):结构简单、对短文本够用、推理便宜、部署成熟。它的弱点是感受野窄、对形变与低对比度鲁棒性一般,且依赖序列顺序假设。
- SVTR(纯 Transformer 式视觉编码 + 局部/全局 mixing):对形变、低对比度、字符间距不均更鲁棒,代价是更吃数据与算力,且在小字符集、短字符串、样本量万级的场景下,增益常被高估——因为它的优势主要来自”用大容量去建模字形变化”,而钢坯号的字形变化主要来自成像退化(极性、反光、断笔),这类变化恰恰是条件归一该解决的,不该交给识别模型硬扛。
选型判据:先把条件归一做到位,再看单模型剩余错误类型。如果剩余错误集中在”形变、粘连、低对比度”,SVTR 值得试;如果剩余错误集中在”先验缺失导致的合理误读”(比如 0/O、1/I、8/B 混淆),换模型没用,那是后处理该解决的(见 3.6)。经验判断(需在你的数据上实测复核):短字符集 + 条件归一到位时,SVTR 相对 CRNN 的端到端增益通常在个位数百分点,而延迟可能是倍数关系——这个交换在产线节拍面前未必值得。
3.5 融合:先算”错误相关性”,再谈”置信度对比”
这是原讨论里最需要修正的一处。”两个模型各自输出置信度,比大小取高的”这句话,隐含了三个前提,缺一个就不成立:
- 分数同尺度:CTC 的序列分数是路径边际的连乘,长度越长分数越低;Attention 解码给的是条件概率连乘,衰减方式也不同。直接比
0.93与0.87,比的不是”谁更可能对”,而是”谁的输出分布更尖锐”。必须先在验证集上做温度缩放(temperature scaling)校准,并用 ECE 检验校准效果,否则”置信度对比”退化成”哪个模型更自夸”。 - 解码结果可对齐:两模型输出长度常常不同(CTC 会折叠重复、可能多出或少一个字)。长度不一致时”字符级加权投票”无法直接做,需要先做序列对齐(编辑距离对齐/动态规划对齐),否则投票是在错位上投票。
- 错误不相关:这是最硬的前提。如果两模型在同一批困难样本上都错,且错法相同,融合等于原地踏步。
所以工程上的正确顺序是:先量化错误相关性,再决定要不要融合。
可操作的度量很简单:取验证集上两个模型的错误样本集合 E1、E2,算交并比 |E1∩E2| / |E1∪E2|,以及”双模型同时错”占单模型错误的比例 |E1∩E2| / |E1|。
- 若
|E1∩E2| / |E1| > 0.7,说明两模型在同一起因上一起失效(通常是姿态、极性、反光——典型的相关性错误),融合的收益上限很低;此时预算应该投向条件归一与业务约束,而不是再加一个模型。 - 若该比例在 0.3~0.6,说明错误有互补性,融合有空间,此时才值得做融合策略设计。
- 无论哪种情况,先算一个 oracle 上限:”两模型中只要有一个对就算对”的准确率。这个数就是融合的理论天花板,它决定了融合到底有多大想象空间——如果 oracle 只比单模型高 0.4 个百分点,整个融合模块就是不划算的。
融合范式按实现代价从低到高:
| 范式 | 做法 | 适用 | 成本 | 风险 |
|---|---|---|---|---|
| 串联兜底 | 主模型先跑,置信度低于阈值才调副模型复核 | 节拍紧、疑难样本占比低(<10%) | 平均延迟增加小(按触发率计) | 阈值定高了延迟爆,定低了副模型形同虚设 |
| 并联 + 校准后分数比较 | 两模型都跑,校准后比较整行分数 | 疑难样本占比高、延迟预算宽 | 延迟近 2 倍 | 整行分数不可拆,错因难定位 |
| 候选集重打分 | 取主/副模型各自 top-k 候选(含编辑距离邻域),用统一打分器(格式约束 + 副模型逐位概率 + 字典距离)重排 | 追求高精度、需要可解释 | 实现复杂,需设计打分器 | 打分器权重难标定,易过拟合验证集 |
| 字符级对齐融合 | 对齐后逐位加权融合概率 | 两模型都输出逐位概率(如逐槽位分类) | 中等 | 需要可靠对齐,错位即错融合 |
值得强调的一点:候选集重打分是这几者里最稳的,因为它把”融合”从”比较两个数”变成了”对同一组候选做统一评估”,天然兼容业务约束(字典、校验位)作为打分项。它的代价是需要一个可解释的打分函数,而这恰恰是工业场景需要的——出问题时你能说清为什么选了这条。
3.6 业务约束解码:性价比最高的一层,也是新增风险的来源
前面说过,剩余错误里最顽固的一类是”合理误读”:0 与 O、1 与 I、8 与 B、字符磨损造成的形近混淆。这类错误换模型、扩数据都收效有限,因为视觉上它们确实难以区分。真正有效的是引入业务先验:
- 格式约束:按产线编码规范做正则/结构校验(段长、字符集、分隔符位置)。
- 校验位:若编码含校验位(模 10/模 36),直接用校验位判错,成本几乎为零。
- 台账白名单:从 MES 拉取当月/当炉在制钢坯号集合,把识别结果与该集合做带权编辑距离匹配(位置权重、形近字符替换代价更小)。
- 工序时序约束:同一炉的坯号通常连号;上一支识别结果可作为下一支的强先验(序列解码里的”转移概率”)。
这一层的收益是数量级的:视觉 CAR 97% 的系统,加上格式+校验+白名单后,”下发到 MES 的正确率”常常能到 99.9% 以上。但它引入了一个新的、更危险的风险:约束会把错读”掰”成另一个合法号。比如实际是 X0216,识别成 X0215,而 X0215 恰好存在于台账里、编辑距离为 1、格式也合法——系统会自信地输出一个错号,比”识别失败转人工”危害大得多。
防护必须写进设计,不是可选项:
- 编辑距离阈值收紧到 1,且必须逐位标注哪一位被”纠正”;纠正位数 ≥2 时不自动采信,直接转人工。
- 纠正只能发生在”形近字符集合内”(
0↔O、1↔I、8↔B、5↔S等),跨字符集的纠正一律不自动通过——否则等于允许系统任意改写。 - 强前缀校验:同炉/同浇次的前缀必须与台账一致;前缀不符时不允许只改后缀来”凑”一个合法号。
- 保留原始视觉结果,与纠正后结果一并入库,便于事后追溯是”读错”还是”改错”。
- 统计纠正采信率与纠正正确率,作为独立监控指标;这两个指标恶化,说明白名单或形近表已经漂移。
用一句话概括这一层的定位:业务约束是”提精度最便宜、也最容易制造静默错误”的一层,它必须有闸门。
四、数据工程:3.6 万张到底够不够,用三个口径判断
“数据够不够”这个问题没有绝对值,只有三个可测量的口径。
口径一:按任务拆分的有效样本量。
- 检测:3.6 万张、每张 1
2 个目标,即 3.6 万7 万个实例,配合预训练权重微调,量是充足的。真正决定效果的是覆盖度:姿态种类、光照极性、表面状态(氧化皮/油污/划痕)、字符组合的分布,是否覆盖了产线实际会遇到的组合。 - 识别:3.6 万条文本行,若平均 10 字符则约 36 万字符样本。字符集若是”10 数字 + 少量字母”,单字符样本数万,充足;若是 36 个字符,平均万级,仍可微调。但真实分布是长尾:某些字符出现极少(某些字母只出现在特定前缀里),这些字符的样本可能只有几百,会成为错误集中区。要先算一遍字符频次直方图,把 < 500 的字符列为长尾清单,单独补数据或合成。
- 融合:验证集的绝对样本量与分层覆盖比总量更重要。5400 张验证集做普通调参够,但要做”逐字符校准”和”错误相关性统计”,某些字符在验证集里可能只有几十个样本,校准曲线会抖。建议按”字符 × 姿态 × 极性”分层抽样,验证集不低于 8000,且长尾字符保证每类 ≥ 200。
口径二:学习曲线。 用 10%/25%/50%/75%/100% 数据分别训练同一配置,看验证集 SAR 是否还在明显上升。如果 100% 处仍有大幅提升,说明数据不足;如果 75%→100% 提升 < 0.3 个百分点,说明这一维已饱和,继续堆数据的边际收益很低,该转向条件归一或后处理。这比任何”经验数字”都可靠。
口径三:错误类型分布。 这是最被忽略的口径。数据”够不够”的真正含义是”是否覆盖了会引起错误的因素“。把验证集错误按五类失效模式归因:如果 60% 的错误是姿态/极性导致,扩 1 万张同分布数据毫无意义;如果 30% 错误是长尾字符,那才需要定向补数据。扩数据要扩在错误分布上,而不是扩在总量上。
划分纪律也得说清:按生产批次/时间段/炉次划分,不能随机划分。同一支坯的连拍帧、同一炉的连续坯高度相似,随机划分会让验证集里塞满训练集的”邻居”,指标虚高 3~5 个百分点,上线后原形毕露。
五、训练编排与增强的边界
按四阶段推进,每阶段有独立的验收闸门,过不了不进下一阶段:
- 检测/配准:mAP@0.5 与”框内背景占比”双指标(后者更贴近下游需求)。冻结主干、微调头部,输入尺寸按边缘算力定(640 或 1024)。验收:框内字符完整率 ≥ 99.5%。
- 姿态分类器:4 类(或按实际姿态数),目标准确率 ≥ 99%,且必须检查每类的召回(180° 错判为 0° 是最贵的错误,因为它会输出”看似正常”的乱序字符串)。验收:各类召回 ≥ 98%。
- 识别模型:先用合成/半合成做预训练,再真实数据微调,最后做混合增强微调。使用 OHEM(在线困难样本挖掘)或按置信度加权的采样,把梯度集中到困难样本上。验收:SAR ≥ 目标(按业务定,见第七节)、长尾字符 CAR 单独达标。
- 融合与后处理:在独立于训练与验证的测试集上网格搜索权重/阈值,用”人工复核率—错号率”曲线选工作点,而不是选”准确率最高点”。
关于增强与合成,边界要划清:
- 有效增强:模拟真实退化——极性翻转、局部高光斑、方向抖动、透视、运动模糊、对比度压缩、氧化皮遮挡贴片(从真实无字区域截取的纹理)。这些在分布内,能提升鲁棒性。
- 危险的合成:用字体渲染凭空生成”钢印字符”,再贴到金属背景上。这类数据学到的是”渲染字体的形状分布”,与真实冲压的凹陷阴影、边缘塑性变形差异很大,容易引入 domain gap,表现为”合成集上 99%,真机 92%”。若要用,必须做真实字符粘贴(copy-paste):从真实样本里抠出单个字符(含真实阴影与纹理),贴到真实背景上,只改组合与位置——这样只扩”组合覆盖”,不改变”字形分布”,是一次分布内的插值。
- 合成数据的准入标准:在真实测试集上评估,若合成增量在真实集上不带来提升,就不要继续投入。
六、部署与运行:先算延迟预算,再选硬件
工程上最常见的返工,是模型训练完才发现节拍不够。正确顺序是先算预算:
1 | 单件可用时间 T = 60 / 产线节拍(件/分钟) 秒 |
识别模块的延迟按”触发率 × 副模型延迟”算,而不是按”两个模型都跑”算:
1 | 平均识别延迟 ≈ L_main + p × L_second |
若 p 在 5%10%,串联兜底的平均开销只增加 5%10%,这就是它比并联更划算的原因;若 p 超过 30%,串联的延迟优势消失,此时要么提高条件归一质量把 p 压下去,要么接受并联并增加算力。
部署要点:
- 推理后端:TensorRT(NVIDIA 边缘/服务器)或 ONNX Runtime(CPU 工控机)。INT8 量化的校准集必须用真实困难样本(反光、低对比度、油污),用干净样本校准会在现场掉点,且掉得很隐蔽。
- 硬件位置:钢厂现场高温、粉尘、振动,相机与工控机要分开布置,机柜配正压散热与滤网;边缘端选型按”识别模型 + 余量”倒推,不要按检测模型的算力反推。
- 并发结构:采集、推理、后处理拆成独立线程/进程,用有界队列 + 丢帧策略(宁可丢帧补拍,不可堆积延迟);GPU 侧做小批合并(batch=2~4)提升吞吐,批大小按节拍可容忍延迟回调。
- 降级链路:检测失败 → 重拍一次(改变曝光/补光);仍失败 → 触发声光提示 + 人工录入,并把图像存入疑难样本库。降级必须显式设计,不能让系统”没结果就卡住节拍”。
- 监控指标(按班次统计):复核率、错号率、各失效模式占比、姿态分类各类召回、平均/P95 延迟。其中错号率是唯一不能被”准确率”掩盖的指标,必须单独建表。
七、验收标准:把”正确率”换成可追责的指标
工业场景里”准确率 99%”这句话没有意义,因为它不区分”读错但转人工”和”读错还下发”。建议按下面的口径定义(数值需按业务实际定,此处为方法论):
| 指标 | 定义 | 为什么必须单独存在 |
|---|---|---|
| SAR(整行准确率) | 整串完全正确的比例 | 衡量视觉能力上限 |
| CAR(字符准确率) | 单字符正确率 | 定位长尾字符弱项 |
| 漏检率 | 未输出任何结果的比例 | 影响节拍与人工负荷 |
| 复核率 | 转人工的比例 | 直接等于人力成本 |
| 错号率 | 未经人工、直接下发且最终判定错误的比例 | 唯一与质量事故挂钩的指标 |
| P95 延迟 | 95 分位端到端延迟 | 决定是否丢帧、是否卡节拍 |
上线闸门建议写成”双阈值”:SAR 达标 且 错号率低于约定值 且 复核率低于产线可承受值。三者同时满足才放量,否则先灰度一个工位跑两周,用真实数据把”复核率—错号率”曲线跑出来,选工作点。
八、选型决策树
flowchart TD
    A["识别率不达标"] --> B{"失败样本归因:五类失效模式占比"}
    B -->|"姿态/极性主导"| B1["先做条件归一:4类分类 + 极性归一 + 光学改造"]
    B -->|"定位为主"| C{"端面位置是否稳定?"}
    C -->|"稳定"| C1["固定ROI + 模板配准,免训练"]
    C -->|"不稳定且水平框背景>50%"| C2["OBB 旋转框 + 透视校正"]
    C -->|"不稳定但背景可接受"| C3["HBB 检测 + 姿态分类器"]
    B -->|"字符退化为主"| D{"钢坯号是否定长?"}
    D -->|"定长"| D1["逐槽位分类:可给逐位置信度"]
    D -->|"变长/粘连严重"| D2["序列识别 CTC:先 CRNN 基线"]
    D -->|"长度固定但存在形变"| D3["CRNN 基线 → 再看 SVTR 增益"]
    B -->|"合理误读为主"| E["业务约束解码:格式 + 校验位 + 台账白名单"]
    D1 --> F{"错误相关性 |E1∩E2|/|E1|"}
    D2 --> F
    D3 --> F
    F -->|"> 0.7"| F1["不做融合,回到条件归一与后处理"]
    F -->|"0.3~0.6 且有 oracle 空间"| F2["串联兜底或候选集重打分"]
    F -->|"< 0.3"| F3["并联 + 校准后比较,或逐位融合"]
图 2:选型决策树。注意第二条主分支的判据是”错误相关性”,这是决定融合是否值得的唯一入口。
九、风险清单
| 风险 | 触发条件 | 后果 | 处置 |
|---|---|---|---|
| 姿态分类把 180° 判成 0° | 形近镜像字符、训练集该类样本少 | 输出看似正常的乱序号,且置信度不低 | 该类样本加权采样;低置信时四方向全跑取优 |
| 白名单”掰号” | 编辑距离 1 的合法邻居存在 | 静默错号,最危险 | 只允许形近集合内纠正;纠正位 ≥2 转人工;留原始结果 |
| 反光斑覆盖笔画 | 补光角度不当、表面状态突变 | 该部分样本不可恢复 | 光学改造;评估时单列不可恢复集 |
| 合成数据 domain gap | 纯字体渲染贴图 | 合成集高、真机低 | 只做真实字符 copy-paste;以真实测试集验收 |
| 验证集泄漏 | 随机划分同炉连续坯 | 指标虚高 3~5 点 | 按批次/时间划分,分层抽样 |
| 引擎/字体/墨水变更 | 喷码机更换、钢种切换 | 分布漂移,准确率断层下降 | 变更即回归测试;建立漂移监控与快速微调通道 |
| 节拍不匹配 | 疑难样本触发率被低估 | 堆积延迟、丢帧 | 先用验证集统计 p;有界队列 + 丢帧补拍 |
结语
把这件事压缩成一句话:钢坯号识别的本质不是”选一个更强的 OCR 模型”,而是”用最少的代价把图像条件、姿态条件、业务条件都归一,让模型只负责它真正擅长的那一小段判断”。
按投入产出排序,我会这样分配预算:
- 归因(一周):500 张失败样本按五类失效模式打标,得到分布图。这一步决定后面所有决策,不做就是在赌。
- 条件归一(最优先):姿态 4 类分类 + 极性归一 + 补光/偏振改造。钢坯场景下这一步的收益通常最大。
- 业务约束解码 + 闸门:格式、校验位、台账白名单,配好防”掰号”的四条防护。
- 单模型识别基线:定长优先逐槽位分类,否则 CRNN;SVTR 作为增益项,用真实测试集验证边际收益。
- 融合:只在错误相关性统计给出空间时才做,优先候选集重打分,而非分数比大小。
至于”3.6 万张够不够”:够不够不由张数决定,由错误分布和学习曲线决定。先把基线跑出来、把归因分布画出来,答案自然会出现——而且往往比预期更早饱和,省下的预算正好投到条件归一和后处理上。
图片示例